案例 9:智能聊天机器人
案例 9:智能聊天机器人
本案例实现 Ascend Edge Chat:一个部署在昇腾边缘设备上的文字聊天服务。它将浏览器文字界面、带 Bearer 鉴权的 OpenAI 兼容网关和 NPU 推理后端分成三个进程。网关可以连接 MindSpore worker,也可以连接固定的 ACL/OM worker,但一次只允许一种已锁定后端。
本案例 v0.2.0 有两条独立发布路径:Ascend310B1 / 20T 使用 Qwen1.5-0.5B-Chat 与 MindSpore/MindNLP;Ascend310B4 / 8T 使用 Qwen2.5-0.5B-Instruct 静态 KV、公开 Hugging Face 工件和原生 ACL。文字聊天是两条路径共同验收的发布能力。源码包含默认关闭的浏览器与板端双模式语音控制面,但 ASR/TTS、USB/3.5mm 录放音、HTTPS 浏览器语音和设备协议均不能由文字聊天结果推导。教学目录还保留其他技术实验;模型是否能运行与中文回答质量分开判断。8T 与 20T 的工件、性能和质量证据不能互相继承。
20T 主链使用 MindSpore/MindNLP 直接加载锁定 revision 的 model.safetensors、tokenizer 与配置,并在 Ascend context 中执行自回归生成;不需要先把该 LLM 转换成 OM。8T 主链则使用公开锁定的 Qwen2.5 静态 KV ONNX 与 B4/CANN8 OM,固定序列长度、KV cache 输入顺序和目标 SoC,再由 PyACL 每步执行一个 token。两条路线使用相同公开模型名,但内部模型、端口、输出预算和验收证据完全分开;不能把某块板的 OM 当作另一块板的工件。
学习目标
完成本章后,你应能:
- 说明浏览器、网关、推理 worker 和 NPU 的职责边界;
- 用固定模型锁文件验证权重、tokenizer 和配置文件;
- 部署 OpenAI 兼容的 JSON 与 SSE 文字聊天接口;
- 理解局域网网页未鉴权的风险,以及为什么 Bearer 密钥不能进入浏览器;
- 为一个新模型设计受控的 Provider、模型配置、工件锁和板端验收流程;
- 区分“技术可运行”“输出质量”和“正式发布准入”三个不同结论。
系统架构
浏览器不接触模型和网关密钥。密钥保存在 UI 服务进程中;请求经回环地址上的网关鉴权后,再由网关转发给已选择的后端。20T MindSpore worker 一次只加载一个模型 profile;教学模型切换会停止旧 worker、启动指定 profile、检查健康状态并清空会话。8T ACL 后端是固定外部 worker,页面只检查其健康状态,不允许切换或重启模型。客户端不能提交任意模型路径、端口或替换模型代码。
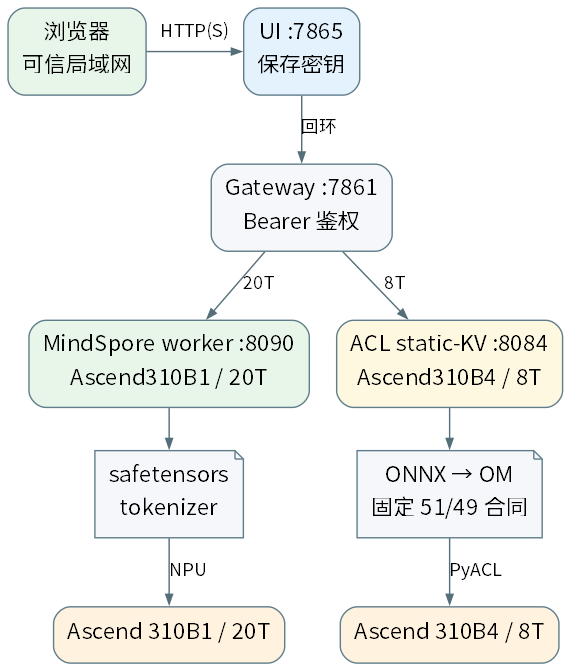
端口承担不同角色,两个 NPU 后端互斥:
| 端口 | 绑定地址 | 职责 | 安全要求 |
|---|---|---|---|
7865 | 0.0.0.0 | 浏览器文字页面 | 仅可信局域网;没有网页登录 |
7861 | 127.0.0.1 | OpenAI 兼容网关 | Bearer 鉴权 |
8090 | 127.0.0.1 | 20T MindSpore worker | 不向网络暴露 |
8084 | 127.0.0.1 | 8T ACL/OM static-KV worker | 不向网络暴露,模型固定 |
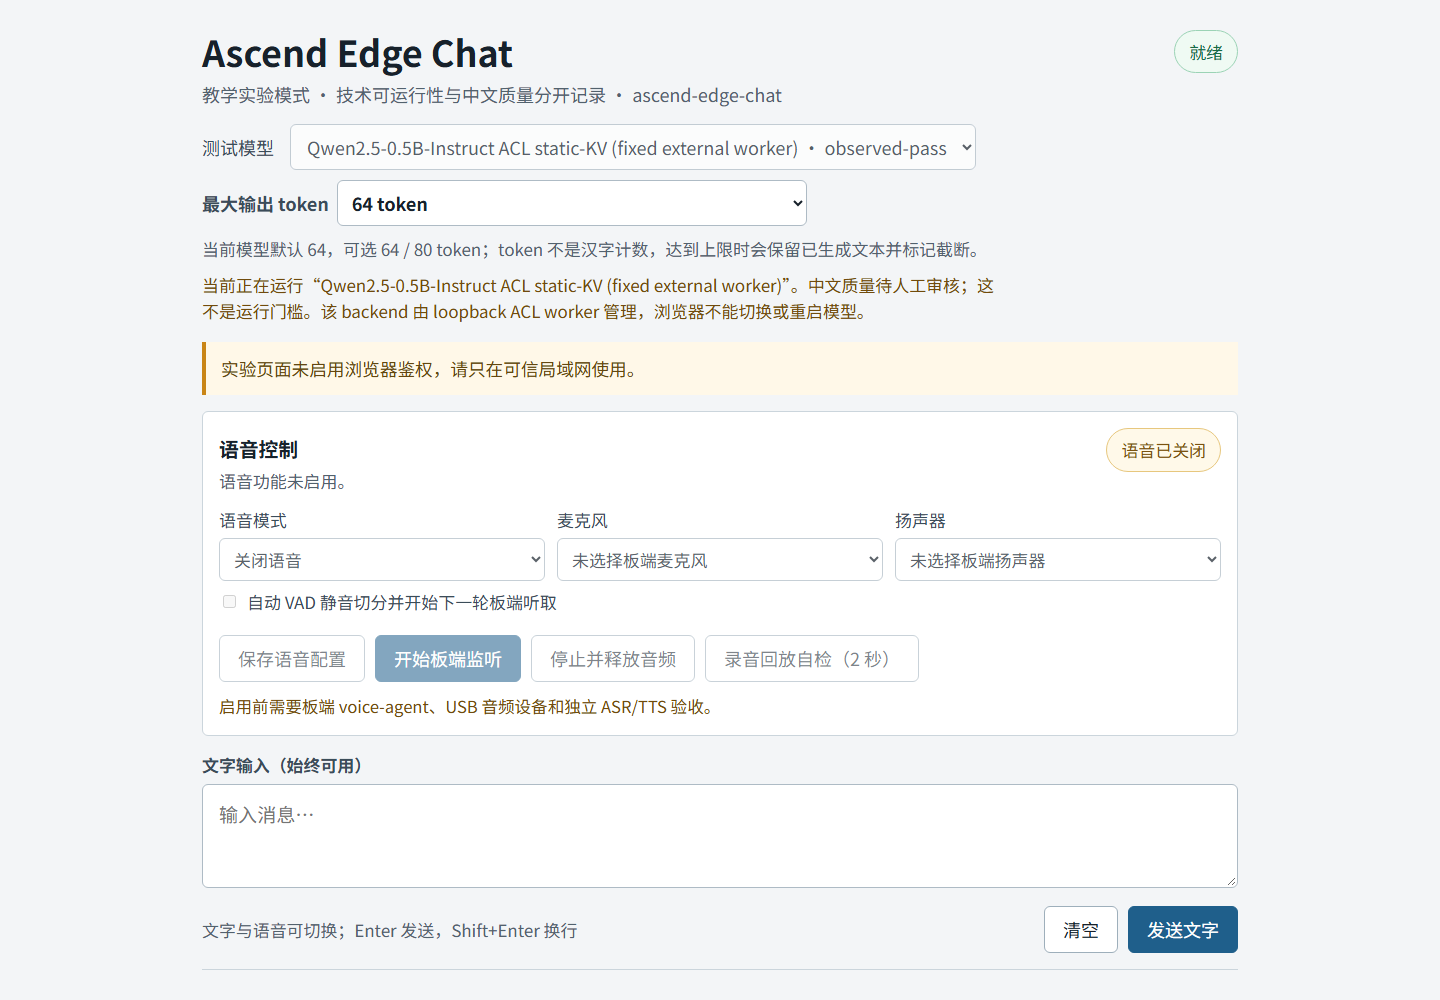
网页没有浏览器登录功能。因此,同一可达网段中的主机都可以发送消息;当语音控制面启用时,还可读取脱敏语音状态,并请求 voice-agent allowlist 中的板端音频模式/设备选择。voice-agent 自身仍只监听回环地址,页面不能传入 ALSA 路径、模型路径或 shell 命令。不要做端口映射,不要将 7865 放到公网反向代理之后,也不要在不可信网络使用本页面。
双模式语音交互(设计中,未验收)
语音扩展有两个互斥的音频所有权模式,二者不能互相替代验收结果:
| 模式 | 麦克风与扬声器所有者 | 关键边界 | 当前状态 |
|---|---|---|---|
board | 20T 板连接的 USB/3.5mm 设备 | voice-agent 直接打开 ALSA,浏览器只看状态/文字 | 仅设备枚举事实;语音闭环 untested |
browser | 访问页面的浏览器 | 浏览器采集/播放,UI 代理到 loopback voice-agent | HTTPS、权限、音频和闭环均 untested |
板端模式的路径是:
USB 麦克风 -> voice-agent -> VAD -> ASR -> :7861 网关 -> :8090 worker
USB 音箱 <- voice-agent <- TTS <- 完整文本或按句文本第一版板端模式必须半双工运行:LISTENING -> SPEECH -> SILENCE_HOLD -> ASR -> LLM -> TTS -> PLAYING -> COOLDOWN。 播放时停止采集,或在将来以独立证据验证回声控制;不能一边播放一边把扬声器声音当作下一轮输入。VAD 阈值、静音时长、最大话语时长和冷却时长均为待测参数,不能从文字聊天的成功推导。
浏览器模式的路径是:HTTPS 浏览器录音 -> UI 代理 -> loopback voice-agent -> ASR -> 网关/worker -> TTS -> UI 代理 -> 浏览器播放。远程浏览器的麦克风权限要求安全上下文;当前 http://<board-ip>:7865/ 的文字页面不能被当作浏览器录音已可用的证据。浏览器不能直接访问 127.0.0.1:7862,因为那是浏览器自身的 loopback;也不能访问开发板 ALSA 或直接访问 voice-agent。
当前语音核心的源码合同已限制为 disabled、browser 和 board 三种模式。browser 模式只处理受限的 16 kHz、单声道、S16 WAV;board 模式才会枚举和打开 ALSA。源码合同不等同于当前 20T 语音服务、ASR 或 TTS 已通过。
20T 板的 ALSA 枚举会随 USB 外设连接状态变化。2026-10-20 的只读快照曾看到板载 ascend310b ALSA 卡的播放节点 /dev/snd/pcmC0D0p、采集节点 /dev/snd/pcmC0D1c,以及 Jieli USB Composite Device 的采集节点 /dev/snd/pcmC1D0c;未看到 USB playback PCM。2026-10-21 的一次重新枚举只保留板载 card 0,Jieli USB 设备已不在当前系统中;连接 UGREEN 1080P 摄像头后,系统又枚举到 hw:1,0 的 USB capture 端。其实际参数是 S16_LE、双声道、16–48 kHz,不能套用强制 单声道采集;语音模块会在内存中下混为 ASR/VAD 所需的 16 kHz 单声道 PCM。没有 USB playback PCM 条目,且两次快照中节点均为 root:audio、模式 0660, HwHiAiUser 未显示在 audio 组中。USB 枚举不等于已成功录音或播放;实际启用前,管理员需按当前板端枚举审查账户权限,例如选择加入 audio 组后重新登录并用 id -nG 复核,不能让服务以 root 身份绕过权限。
两种模式的 USB/3.5mm 采集播放、权限生效、HTTPS、浏览器权限、VAD、ASR、TTS、隐私和十轮闭环均为 untested。ASR/TTS 即使先在 CPU 隔离进程运行,也只能说明音频服务路径,不构成 NPU 语音推理证据。详细的模型锁、隐私边界和分模式人工验收门见语音模式与板端终端方案。
发布模型与工件锁
模型来自 Qwen1.5-0.5B-Chat。程序不会根据模型名称自动下载任何版本,而是读取 configs/release-model.json 中的固定 revision、文件名、大小和 SHA-256。
需要的工件包括:
| 文件 | 用途 |
|---|---|
model.safetensors | 模型权重 |
tokenizer.json | tokenizer 数据 |
config.json | 模型结构配置 |
tokenizer_config.json、vocab.json、merges.txt | tokenizer 元数据与词表 |
generation_config.json | 生成元数据 |
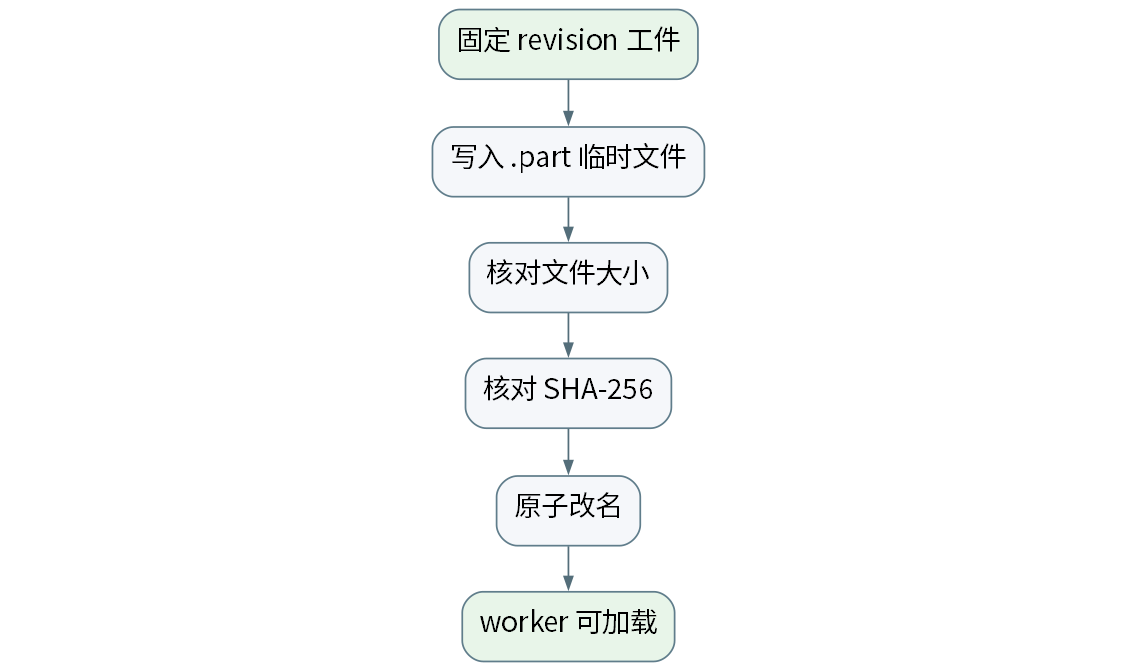
下载或离线导入都必须执行相同的完整性流程:
模型目录应位于源代码目录之外,例如 /opt/ascend-edge-chat-data。模型、日志、缓存和报告都不应提交到 Git。源代码使用 Apache-2.0;锁定的 Qwen revision 使用 Tongyi Qianwen Research License Agreement,仅覆盖非商业用途;商业使用需要向模型发布方另行取得许可。不能从代码许可证推断模型使用权。
20T 正式发布锁是 configs/release-model.json 与 configs/release-artifacts.lock.json。8T 正式发布锁是 configs/release-8t-static-kv.lock.json,固定公开工件仓库 zhouxzh/ascend310b-llm-om-zoo 的完整 revision、上游 Qwen2.5 基座 revision、九个文件的字节数和 SHA-256。下载器只接受固定 hf-mirror.com 地址,拒绝路径穿越和符号链接,并在数据目录内派生 schema-2 运行时 OM/tokenizer 锁。模型、ONNX、OM 和派生锁都不进入 Git。
教学实验使用 configs/tutorial-model-catalog.json 展示模型的技术状态、质量状态和失败原因,使用 configs/tutorial-models.json 作为显式 worker registry,并使用 configs/tutorial-artifacts.lock.json 校验教程模型的 repository、revision、每个文件的字节数和 SHA-256。页面会按当前 SoC、缓存完整性和固定哈希决定是否可启动;历史 8T/20T 证据仍可展示,但不能因为另一种 SoC 曾经通过就允许本板启动。
环境准备
本案例不安装或升级驱动、固件、CANN、OPP、MindSpore 或 MindNLP。所有启动进程必须使用统一 conda ascend 环境(Python 3.9.25、PYTHONNOUSERSITE=1),并在同一个 shell 中激活 CANN 环境;不得以 base 或 ~/.local 补齐依赖。
cd /opt/ascend-edge-chat
export ASCEND_EDGE_CHAT_CONDA_ENV='ascend'
source /usr/local/miniconda3/etc/profile.d/conda.sh
conda activate "$ASCEND_EDGE_CHAT_CONDA_ENV"
python -m pip install --no-deps .
export ASCEND_EDGE_CHAT_DATA_DIR=/opt/ascend-edge-chat-data
cp configs/release.env.example .env
chmod 600 .env
编辑 .env,将 ASCEND_EDGE_CHAT_GATEWAY_API_KEY 改成至少 24 个 ASCII 字符的随机值。不要将密钥写入源代码、浏览器 JavaScript、终端截图或 Git 提交。
若预检发现当前环境缺少 FastAPI、Pydantic、Uvicorn 或 dotenv,不要依赖 user-site。应先准备经过审核的本地 wheel 目录,再执行带哈希的最小服务依赖安装:
export ASCEND_EDGE_CHAT_WHEELHOUSE=/opt/ascend-edge-chat-wheelhouse
bash scripts/verify/install-service-dependencies.sh
该脚本使用 --no-index --no-deps --require-hashes,只安装发布锁中的服务层依赖,不升级 CANN、MindSpore、MindNLP,也不安装新的模型推理框架。
执行环境预检:
bash scripts/verify/release-preflight.sh预检会强制核对 ascend、Python 3.9.25、aarch64 ABI、PYTHONNOUSERSITE=1、PyACL、MindSpore/MindNLP 与 CANN 的兼容组,显示 npu-smi info,核对所有模型文件,并解析网关配置。worker 在加载前还会检查目标设备的 HBM 账本余量;该检查能提前阻止已知高占用失败,但通过不等于模型一定可被 MindSpore allocator 装入。预检失败时应先定位环境、CANN、HBM 或模型文件问题;不能为了获得响应而自动改用 CPU、云端或其他推理框架。
8T 发布使用同一个 ascend 环境,但不要求本进程导入 MindSpore。安装扩展闭包时使用 configs/release-8t-service-requirements.txt 和同一个哈希安装脚本;随后执行 scripts/verify/release-8t-preflight.sh。该预检核对 B4 SoC、PyACL、NumPy、tokenizers、网关配置、UI 外部 worker 模式以及九个公开工件。统一环境可以同时安装 MindSpore 和 ACL 依赖,但 ACL worker 自己的进程不得已经导入 MindSpore、Torch、Transformers 或 ONNX Runtime。
获取或导入模型
通过镜像下载时:
bash scripts/import/download-model.sh通过离线目录导入时:
bash scripts/import/import-model.sh /mnt/offline/qwen1.5-0.5b两种方法都会先写入临时文件,再检查服务端声明长度、本地实际长度和 SHA-256。离线目录还必须带有 offline-bundle.manifest.json,声明来源 repository、revision、license 与每个 artifact 的字节数/哈希;验收报告会明确标记为 offline-bundle,不能冒充 HF 在线下载。校验失败的临时文件会被删除,已验证的目标文件不会被覆盖。可在启动前再次核验:
ascend-edge-chat verify --data-dir "$ASCEND_EDGE_CHAT_DATA_DIR"启动服务
分别打开三个终端,在项目根目录执行:
# 终端一:NPU worker
bash scripts/run/start-worker.sh

# 终端二:网关
bash scripts/run/start-gateway.sh

# 终端三:文字页面
bash scripts/run/start-ui.sh
三个脚本都在前台运行,便于查看错误并按 Ctrl+C 停止对应进程。不要使用宽泛的进程名匹配来结束其他 NPU 任务。
命令行入口等价于:
ascend-edge-chat worker
ascend-edge-chat gateway --check-config
ascend-edge-chat ui
8T 静态 KV 发布路径
8T 不运行 MindSpore worker,而是从公开 Hugging Face 工件仓库下载模型并在 8084 启动固定 ACL 服务:
cp configs/release-8t.env.example .env
chmod 600 .env
# 编辑 .env,替换 ASCEND_EDGE_CHAT_GATEWAY_API_KEY
bash scripts/import/download-static-release.sh
bash scripts/verify/release-8t-preflight.sh
bash scripts/run/run-release-8t.sh
该路径的拓扑是 :7865 -> :7861 -> :8084。网关继续只暴露 ascend-edge-chat,内部模型 id 为 qwen2.5-0.5b-instruct-static-kv-1024-fp32-acl-om;客户端不能指定内部模型或端口。8T 默认生成 64 个 token,硬上限为 80,浏览器模型选择器被禁用。服务健康必须同时满足 ready=true、healthy=true、backend=acl_om、sequence_length=1024 和 descriptor_validated=true,否则 UI 返回降级状态并拒绝聊天。
8T 的公开工件锁固定 ONNX、tokenizer、controller contract、B4 OM、descriptor、两套来源锁和 Apache-2.0 许可证,共九个文件。板端生成 OM 的旧实验仍保留为诊断资料,但正式路径使用公开 HF revision 中与 B4/CANN8 匹配的 OM,并在每次服务启动前重新验证字节数和 SHA-256。
选择教学模型
页面会列出教学目录。selectable=true 表示该模型有技术证据;但真正可启动还要求当前 SoC 在 registry 中有独立声明、缓存文件齐全且所有字节数/SHA-256 与教程锁一致。blocked/not-run 表示尚未完成 loader、工件或 NPU 前置门,暂时不能启动。页面选择不同模型后会执行受控的 worker 重启:先检查固定 registry、当前 SoC 与本地 artifact lock,停止当前 worker,使用 CANN 启动脚本加载目标 profile,并等待 /health 返回目标模型。切换成功后会清空浏览器会话;若目标启动失败,会尝试恢复原模型。它不是在同一进程中同时加载多个模型,也不允许网页提交路径、shell 命令或 Python 表达式。生成期间,页面会禁用选择器;收到终止 SSE 事件后,服务端还会等待一个短暂的流式收尾窗口再开始切换。
export ASCEND_EDGE_CHAT_PROFILE=qwen2-1.5b-instruct-mindspore
ascend-edge-chat worker \
  --profile "$ASCEND_EDGE_CHAT_PROFILE" \
  --registry configs/tutorial-models.json
如果选择的模型没有完整本地缓存,页面会在停止当前 worker 前报告失败;它不会 自动改用 CPU、云端或未锁定的远程权重。下面的命令仍可用于无浏览器的恢复操作, 或者在自动回滚也失败后恢复默认 profile:
ascend-edge-chat worker --profile qwen1.5-0.5b-chatapp.py 与 text_chat_app.py 仅为短期兼容包装器。新部署和二次开发脚本应使用 ascend-edge-chat 命令。
调用 OpenAI 兼容接口
网关公开模型名固定为 ascend-edge-chat。调用方必须携带 Bearer 密钥。
curl http://127.0.0.1:7861/v1/models \
  -H "Authorization: Bearer $ASCEND_EDGE_CHAT_GATEWAY_API_KEY"

curl http://127.0.0.1:7861/v1/chat/completions \
  -H "Authorization: Bearer $ASCEND_EDGE_CHAT_GATEWAY_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "model":"ascend-edge-chat",
    "messages":[{"role":"user","content":"请用一句中文介绍你自己。"}],
    "temperature":0,
    "top_p":1,
    "max_tokens":32
  }'
将 stream 设置为 true 可获得 Server-Sent Events。网关会将 worker 的内部模型名改写为公开模型名,再把增量返回给客户端。
接口限制如下:
- 仅接受
system、user、assistant三种角色; - 仅支持 greedy 解码:
temperature=0、top_p=1; - 最大上下文为 1024 token;20T MindSpore 网页默认输出预算为 128 token、硬上限为 256 token;8T 静态 KV 默认 64 token、硬上限为 80 token;
- 单进程、单请求串行执行;
- 请求体最大 256 KiB;
- 超时或运行时错误时 fail-closed,不自动切换后端。
浏览器会话只保存在 UI 进程内存中,最多保留 4 条消息和 4,000 个字符。清空会话、重启页面服务或停止进程都会丢弃这些消息。
验收方法
不能用“服务已启动”代替模型验收。每个目标板都应独立记录以下证据:
- SoC、CANN、Python、驱动、目标框架版本和全部模型工件 SHA-256;
- worker NPU 初始化和单 token 生成;
/health、/v1/models、JSON 与 SSE;- 目标允许的输出档位及其 UTF-8、结束原因和截断检查;当前 20T 覆盖
8/16/32/64/128/256,8T 覆盖8/16/32/64,上限 80; - 连续 10 轮短请求的 PID、RSS、文件描述符和 NPU 快照;
- 浏览器页面通过网关完成一次对话;
- 明确 warmup、轮数、百分位算法的首 token、总延迟和 token/s;
- 保存中文和英文完整响应,分别标注“可理解、部分可理解、不可理解”;
- 将技术门和质量门分别写入报告,不因为质量失败而删除可运行模型。
本案例在 20T 参考硬件的历史测量中记录过约 672 ms 的首 token p50、约 1.31 s 的完成 p50 与约 1.53 token/s 的吞吐 p50。该数据只描述特定日期、环境、负载和提示词条件,不能外推到 8T、另一块 20T 板、不同 CANN、不同模型 revision 或并发负载。
8T 正式路径必须在干净的公开 GitHub commit 上执行:
ASCEND_EDGE_CHAT_MODEL_SOURCE=hf \
  bash scripts/verify/run-release-8t-acceptance.sh
验收报告必须同时绑定公开 Git commit、干净工作树、Hugging Face revision、九个工件哈希、B4 SoC、schema-2 OM 锁、51 输入/49 输出 descriptor、JSON、SSE、中文探测、长度、稳定性和实测延迟。源码工作树不干净、提交不是公开 main 当前提交、HF revision 不固定或任一哈希不一致时,报告必须是 blocked。
教学模型的实测结果与原因
下表是本案例已有板端证据的摘要。observed-pass 只说明机器和接口路径 通过;它不等同于中文回答优秀。相反,quality_status=failed 也不等同于 NPU 不能运行。
| 模型 | 技术结果 | 质量结果 | 现象原因 |
|---|---|---|---|
| Qwen1.5 0.5B | 20T 机器门通过 | 待人工审核 | 默认基线,先用它验证环境和协议 |
| Qwen1.5 1.8B | 20T 机器门通过 | 待人工审核 | 更大模型,速度和内存需要单独测量 |
| Qwen2 0.5B/1.5B | 2026-10-18 20T:JSON/SSE、长度、10 次稳定性通过(Qwen2 0.5B);Qwen2 1.5B 另有长输出证据 | 语义质量待人工复核 | 当前 20T 教学验收使用 Qwen2 0.5B;Qwen2-1.5B 已定位并修复缺失 ChatML 模板,不能把模板问题写成 NPU 加载失败 |
| Qwen2.5 0.5B | 修正客户端超时后机器门通过 | 待审核 | 早期 30 秒超时误杀了测试,不能当作模型崩溃 |
| Qwen2.5 1.5B | 低占用路径可运行;另有高占用 Alloc failed | 历史探测含 U+FFFD,语义质量待复核 | 内存占用路径和文本解码问题必须分开记录 |
| TinyLlama 1.1B | 短请求可运行;长输出退化 | 中文语义质量待复核;历史长输出出现文本完整性/TBE 问题 | 主要面向英文,短 smoke 仍适合课堂复现边界 |
| DeepSeek-R1 Distill 1.5B | 两板有 NPU/API 证据,速度较慢 | 中文语义质量待复核 | <think> 预算和模型行为影响结果,不代表没有 NPU 推理 |
| Qwen3 0.6B | 未进入加载 | 未测试 | 当前 MindNLP 没有 loader,属于前置阻断 |
| MiniCPM3 4B | 未测试 | 未测试 | 专用 loader、权重和内存门尚未完成 |
学生应先复制原始响应,再分析 tokenizer、chat template、finish_reason、 请求的 max_tokens、设备内存和 npu-smi。不要把中文质量表格改写成硬件兼容性结论。
长度、文本完整性与中文语义质量
max_tokens 是本轮最多新生成多少 tokenizer token,不是“最多多少汉字”。 同一段中文可能被分成一个或多个 token;它还受 prompt_tokens + max_tokens <= 1024 的上下文上限约束。20T 页面默认发出 128,普通 Qwen 教学 profile 当前可选 32/64/96/128/192/256;8T 静态 KV 页面默认 64,用户可选 64/80,低于 64 的档位只保留给内部协议和性能诊断,不在正常页面提供。如果模型没有在上限前输出 EOS,接口返回 finish_reason=length,页面会 保留已生成文本并提示截断。这是长度门结果,不是模型崩溃,也不能直接作为中文 质量差的证据。
8T 长度验收还使用固定问题“简单介绍一下昇腾310B”配合 max_tokens=80。实测 prompt 为 38 token,completion 为 41 token,返回 54 个字符并以 finish_reason=stop 正常结束,证明 80-token 上限不是只能返回 空壳的标称值;新的 64-token 默认预算也不会截断这次 41-token 回答。该小模型 的回答出现重复句,所以这项只证明长度和终止协议,中文语义质量仍需单独评审。 复杂回答仍可能在 80 token 上限处返回 length。
max_tokens 也不是显存容量的直接函数。8T 静态图固定使用 1024-token KV 窗口,因此生成 80、128 或 256 token 时,NPU 工作集基本不变。使用临时测试 worker 将 ACL 上限提高到 1024、执行超时提高到 3600 秒后,8T 对 55-token prompt 分别完成了 80、128 和 256 token;256 token 耗时约 1983.8 s, finish_reason=length,worker 仍健康且 NPU 显存维持约 5.9 GB。该 prompt 的理论 context 上限是 1024-55=969 token,但完整生成969 token 的耗时不适合 作为发布交互,也不能把理论值写成已完整实测。
20T MindSpore 路径的正式配置为默认128、平台上限256。相同长输出方法下, 171-token prompt 完成256 token 用时 143.984 s。在临时测试 checkout 中把 worker/gateway/profile 上限提高到1024后,同一 prompt 完成850 token 用时约 507.982 s,又完成853 token 用时 483.612 s,total_tokens=1024 且 worker 健康。因此该次20T测试的最大完成数是 1024-171=853 token。8T 与20T的 数字分别属于自己的运行时和模型,不能互相替代。
8T ACL 的240秒 watchdog 是应用层的 fail-closed 超时。PyACL 同步执行无法从 Python 线程安全中断,超过时限只能取消请求、毒化 backend 并要求重启。历史 方案将 ACL/gateway/UI预算设为 240/270/300 s,并没有硬件规格证明240秒是 精确校准值。8T 的80-token压力请求已耗时约225秒,说明正式上限80与240秒 watchdog只有很小余量;提高正式上限必须同时重新设计超时、取消、流式心跳和 容量预算,而不能只改一个数字。
质量验收必须单独进行。针对每个 profile,以新会话、greedy 解码、max_tokens=256 (或该 profile 的已验证上限)运行同一组 10 条中文提示,保存完整 JSON/SSE、模型 revision、提示与完成 token 数、finish_reason。先标注是否出现 U+FFFD 等文本 完整性异常;finish_reason=length 的回答标为“未完成”,不计入语义失败。随后由 至少两名评审者对相关性、事实性、流畅性和完成度分别打 0/1/2 分,并保留分歧。 只有该人工流程才能把 quality_status 标为通过或失败;历史短预算中的替换字符 只能保留为 tokenizer/解码的待复核观察。
20T 长输出边界实测示例
不要把配置文件中的 max_tokens 当作已验证能力。以 20T 的 Qwen2 1.5B Instruct 为例,在 Ascend310B1、CANN 8.0.0、MindSpore 2.4.10、MindNLP 0.4.1 上,先发现其 tokenizer 目录没有 tokenizer_config.json,默认模板为空。旧通用回退错误使用 Qwen1.5 风格的 <|user|> / <|assistant|>,于是模型在第一轮回答后继续生成下一轮角色标记。将 审核后的 Qwen2 ChatML 模板固定到 profile 后,经网页 SSE 链路的强制长输出测试中: 64 token 在 80.029 s、128 token 在 158.946 s、192 token 在 238.133 s 均跑满,三轮都返回 finish_reason=length,无 U+FFFD 和角色标记, worker 恢复健康。256 token 请求仍在产生长段 SSE 输出后失去 worker 终态, 日志含 TBE main process disappeared 与资源清理警告,而不是显存用尽记录。因此该 profile 的页面下拉菜单和 worker 当前只允许到 192,服务的全局 256 上限仍保留给 需要单独验收的其他 profile。
这组数据说明三件事:token 预算与汉字数无一一对应;速度和可完成的最大长度必须 分开测量;一次 worker 退出只能说明该软件、模型 revision、提示词和 watchdog 组合 的失败,不能外推成整个 310B 产品族不支持该模型。学生应保存每一档的 SSE、 finish_reason、完成 token 数、worker 健康状态和 npu-smi 快照,再更新 profile 的可选档位。
可在板端以如下命令重复长度门。应从较小档位逐级升高,并在前一档 worker 已恢复 健康后才运行后一档:
python scripts/verify/output_budget_probe.py \
  --profile qwen2-1.5b-instruct-mindspore \
  --budgets 128,192 \
  --timeout 330 \
  --output run/output-budget-$(date -u +%Y%m%dT%H%M%SZ).json
该工具调用和网页相同的 SSE 路由。若 worker 消失,它会保留“unavailable”观察, 不能把该次运行写成成功,也不能用配置中的全局上限代替板端结果。
二次开发
新模型不是通过任意请求参数注入路径或 Python 代码。教学模型通过受控 registry 和目录加入页面;正式发布模型仍需要独立锁文件。新模型需要实现 BackendProvider 协议,并提供:
start():加载已验证工件并初始化设备;healthy:报告是否可以继续服务;status():返回不含密钥的运行状态;stream():为一次 greedy 请求产生累计文本与 token 数;close():按确定顺序释放模型和设备资源。
为新模型建立固定 revision、文件大小、SHA-256、tokenizer、chat template、许可证、目标 SoC 和运行时指纹。先完成本地 JSON/SSE 契约测试,再在每一种目标硬件上完成上述 NPU、稳定性、性能和人工质量门。技术门通过即可进入教学目录;质量结论必须原样保留。只有经过独立复核并人工批准的模型才能进入正式发布配置。
板端实测记录
2026-10-18 20T 验收
本轮在 Ascend310B1 / 20T 的真实开发板上,对已经启动的 Ascend Edge Chat 服务执行最终验收。运行中的教学 profile 是 qwen2-0.5b-instruct-mindspore,不是正式发布默认的 Qwen1.5 profile;因此下面的结果只证明该 profile 和该软件组合在当前 20T 板上可运行,不代表其他模型或 8T 也通过。
| 项目 | 实测值 |
|---|---|
| SoC / 档位 | Ascend310B1 / 20T |
| CANN / 驱动 | 8.0.0 / 25.2.0 |
| Python | 3.9.2(base conda) |
| 设备健康 | Alarm,73 C;不作为单独阻塞条件 |
| worker | 127.0.0.1:8090,profile qwen2-0.5b-instruct-mindspore |
| gateway | 127.0.0.1:7861 |
| UI | 0.0.0.0:7865,浏览器页面 HTTP 200 |
| 模型公开名 | ascend-edge-chat |
| 网关契约 | /v1/models、Bearer 拒绝、未知模型拒绝均通过 |
| UI 契约 | /api/config、真实 /api/chat 均通过 |
| JSON / SSE | 两条浏览器同链路请求均为 HTTP 200,finish_reason=stop |
| 长度门 | 8 / 16 / 32 token 达到预算并返回 length;64 token 在生成 46 token 后 stop |
| 稳定性 | 10/10 个短请求成功,返回“测试通过” |
| 中文探针 | 10 条均完成机器链路;回答内容与人工语义质量另行判断 |
| 性能 | 本轮只运行 1 个流式性能样本:首 token 723.051 ms、完成 1370.604 ms、1.459 token/s |
| 验收报告 | 板端 run/case9-acceptance-20261018-20t-spaced2.json(ignored evidence) |
| UI 截图 | 1440×900,保存为 src/experiment/img9/case9-board-20t-ui.png |
| 测试后进程 | UI RSS 约 55.6 MB;gateway RSS 约 53.5 MB;worker RSS 约 3.57 GB |
| 测试后 NPU | 19,540 / 23,673 MB 已用;设备仍可查询 |
本轮第一次运行完整验收脚本时,在没有请求间隔的情况下连续发送请求,稳定性段收到 HTTP 429:
Too many request bodies are being read这属于测试客户端突发请求触发的服务 admission 限制,不是 NPU 推理失败。加入请求间隔和流式收尾等待后,同一服务、同一模型、同一 20T 板通过完整机器验收。因此文档不能把第一次 429 写成模型或设备结论,也不能用第二次结果掩盖服务确实有单请求串行/限流边界。
中文质量仍需单独判断。直接请求“请用一句中文介绍昇腾310B开发板”时,模型返回了英文道歉句,说明这次生成在技术上完成、但内容质量不通过本次中文语义期望;它不会反向否定 NPU/网关/UI 的 observed-pass。
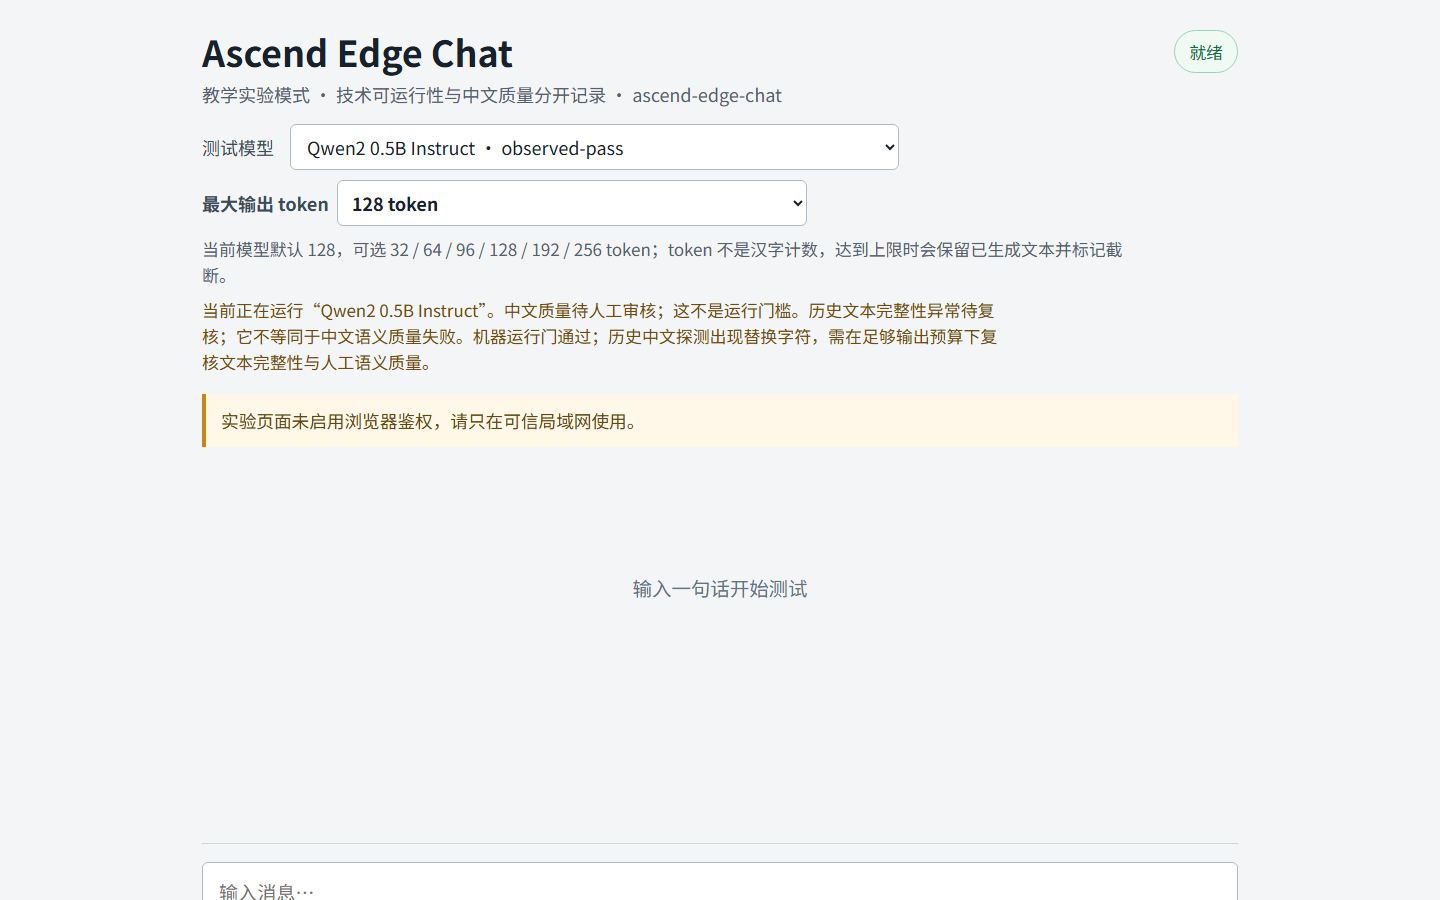
证据等级:环境、worker、gateway、UI、JSON、SSE、10 次短稳定请求为 observed-pass(20T);中文语义质量、长文质量和并发仍为 untested。8T 的结论只来自独立静态 KV 路径,不从本节继承。性能只记录单样本,不把 p50/p95 当成多轮基准。
2026-10-25 8T 发布链验收
本轮在 Ascend310B4 / 8T 上验证了从公开 Hugging Face 工件到 :8084 -> :7861 -> :7865 的正式发布链。模型工件固定为 zhouxzh/ascend310b-llm-om-zoo revision 0f516070e1c0566e3c652d43c488cd3cfbad89a3;基座 Qwen/Qwen2.5-0.5B-Instruct 的公开 checkpoint 另行固定到 revision 7ae557604adf67be50417f59c2c2f167def9a775。
| 项目 | 实测值 |
|---|---|
| SoC / 档位 | Ascend310B4 / 8T |
| CANN / 驱动 | 8.0.0 / 25.2.0 |
| Python | 3.9.25,统一 ascend 环境,user-site 禁用 |
| 公开源码 commit | c11c96eb625403a2e160792c6428f2eaa341018b,干净工作树且等于当时公开 main |
| ONNX | 1,261,082,122 bytes;SHA-256 b4870d…a3c0e |
| tokenizer | 7,031,645 bytes;SHA-256 c03821…e87539 |
| B4 OM | 1,266,010,586 bytes;SHA-256 f6650e…40eb8 |
| descriptor | 51 输入 / 49 输出,24 层 split KV,形状 1×2×1024×64 |
| 运行时锁 | schema 2,绑定 B4、OM、tokenizer、controller contract 和 runtime contract |
| ACL health | ready=true、healthy=true、launch_policy=PASS、descriptor_validated=true |
| gateway | /v1/models 仅返回 ascend-edge-chat;无 Bearer 401,错误模型 404 |
| JSON / SSE / UI | 正式契约均通过;SSE 公开模型名、增量、终止和 usage 完整 |
| 长度门 | 8/16 token 返回 length;32/64 token 在 24 token 后自然 stop |
| 稳定性 | 10/10 个短请求返回“测试通过” |
| 中文探针 | 10/10 完成机器链路;语义质量仍待人工审核 |
| 性能 | 30 个 2-token SSE 样本:首 token p50/p95 10623.506/10656.206 ms,总耗时 p50/p95 10755.880/10786.937 ms,0.186 token/s |
| 模型切换 | 请求其他 profile 返回 409,固定 ACL backend 不允许网页切换 |
| 资源释放 | 手动清理记录 PID 后 8084/7861/7865 均无监听,NPU 显存回落 |
公开 HF 工件中的 B4 OM 可直接用于本次锁定的 CANN 8.0 运行环境。此前在另一台 B4 上从 ONNX 重新 ATC 得到的 OM SHA-256 为 763961…cb507,与本轮公开 OM f6650e…40eb8 不同;两者不能互相替代。正式路径固定公开 OM 哈希,重新转换的结果必须建立新的锁并用目标板完整验收。
正式验收报告为 machine_status=passed,JSON 的 SHA-256 是 6e47b32c5b2b7006ad9ad9e8669d4472396d6a1be49d04fdf395594167df342d。 由于外部命令执行器在 600 秒断开,脚本自带 cleanup trap 未收到完整退出流程;操作者按记录 PID 手动停止三个服务并验证端口、ACL 进程和 NPU 显存均已释放。报告本身在断开前已经写完。
证据等级:公开源码/HF 来源、schema-2 锁、ACL 与 descriptor、gateway/UI、JSON/SSE、长度、10 次稳定性、10 条中文机器探针和 30 样本性能为 observed-pass(8T formal machine)。人工中文语义质量、并发和长期稳定性仍需独立评审;不能继承 20T 的结果。性能很低是每次 ACL 执行只生成一个 token 的静态图特性,不是 API 中转或普通网络延迟。
2026-10-17 历史记录
更早的 20T 记录使用固定 Qwen1.5-0.5B Chat 和低 token 预算,完成了 worker/gateway/UI 启动、一次真实 completion 和 1440×900 UI 截图;它是本案例的历史基线,不与 2026-10-18 的 Qwen2 教学 profile 结果合并。旧原始日志与响应保存在 docs/case-board-runs-20261017/case9/。
8T / Ascend310B4 已使用独立的静态 KV ACL 发布链完成上述短请求验证,不继承本节的 20T MindSpore 结论;两条路径的延迟、HBM 和模型工件不能混合统计。
小结
Ascend Edge Chat 将网页、鉴权网关和 NPU 后端分离,使文字聊天服务具备清晰的网络边界、模型完整性边界和二次开发边界。20T MindSpore 与 8T ACL/OM 通过不同内部端口和工件锁运行,但共同保持 ascend-edge-chat 公共接口和可信局域网边界。后续扩展应以目标板实测证据为准,不能把模型名称、历史实验或另一算力档位的结果直接写成发布结论。