第5章:MindSpore开发基础
第 3 章用 torch_npu 把 PyTorch 模型迁移到昇腾,第 4 章用 PyACL 直接操作运行时和内存;本章介绍第三条路线:在昇腾上用 MindSpore 完成从张量、网络、训练到端侧推理闭环。三条路线并不互斥。PyTorch 迁移适合已有训练脚本的团队,PyACL 适合需要精确控制设备资源的底层工程,MindSpore 则把网络定义、自动微分、图编译和昇腾执行放在同一套框架内,并用 MindIR 作为可交付的中间表示。
本章也承担一个容易被忽略的任务:把“MindSpore”这个词拆开。读者在工程现场看到的其实是四个互相独立、各自带版本的东西:
| 组件 | 职责 | 不能和谁混为一谈 |
|---|---|---|
| MindSpore(全量框架) | 张量、算子、自动微分、训练与 Ascend 图执行 | 不是 CANN,也不是 MindSpore Lite |
| MindSpore Lite | 端侧/云侧轻量推理运行时,加载 MindIR 或 .ms | 与全量 MindSpore 是两个运行时,ABI 与算子集不同 |
| MindNLP | 建立在 MindSpore 之上的 NLP 模型与加载器集合 | 不是 MindSpore 自带模块,loader 覆盖范围随版本变化 |
| CANN / 驱动 / 固件 | 算子编译、运行时、设备访问 | 由不同安装包提供,升级其中一个会让另一些失配 |
全章沿用本仓库的证据标注:documented 表示厂商文档明确给出;inferred 表示由配套关系推得但未在目标板验证;observed-pass 与 observed-fail 表示在记录过的板卡、版本和输入条件下实测成功或失败;blocked 表示前置条件未满足,不等于硬件不支持;not-run 表示尚未执行。
本章有两套互不混用的板端证据。第 5.3 至 5.10 节的框架基础结论全部来自本仓库新增的 samples/chapter5/ 样例,它们在 Ascend 310B4 / 8T 开发板上完整运行过一轮,环境为 aarch64 + CANN 8.0.0 + MindSpore 2.4.10 + MindSpore Lite 2.2.11,原始报告保存在该目录的 outputs/ 下。第 5.11 节的大模型结论来自 Ascend 310B1 / 20T 板上的既有验收记录,入口是 samples/case9/docs/。两块板的算力档位不同,版本结论与性能数字都不得互相引用。
本章定位与学习路径
本章不重复第 3 章的 PyTorch 语法,也不替代第 4 章的 ACL 细节。它回答四个问题:
- MindSpore 在昇腾软件栈里处在哪一层,和 CANN、PyACL 的边界在哪里;
- 如何用 Tensor、
nn.Cell、ops、Dataset写出一个能跑在 310B 上的网络; - 静态图、自动微分和优化器如何组织成一次可复现的训练;
- 模型保存成 CKPT 或 MindIR 之后,如何在端侧推理,以及当前 310B 上哪些路径已经实测通过、哪些仍然阻断。
推荐阅读顺序与前置章节的关系:
| 顺序 | 章节 | 与本章的关系 |
|---|---|---|
| 先读 | 第 2 章 CANN软件栈核心组件解析 | 理解 ATC、算子、运行时如何支撑框架 |
| 先读 | 第 4 章 PyACL 应用开发基础 | 理解设备、Context、Stream、内存的生命周期 |
| 本章 | 第 5 章 MindSpore开发基础 | 框架级开发与 MindIR 交付 |
| 后读 | 第 6 章 DVPP视频处理基础 | 媒体数据在框架外的处理方式 |
| 后读 | 第 9 章 模型量化案例教学 | 量化与精度取舍 |
阅读本章需要的基础:Python 基础(附录 3)、会使用 SSH 登录开发板(附录 1、附录 2)、完成 CANN 环境变量配置(第 2 章)。若尚未在板上跑通 import acl,请先回到第 4 章,因为本章所有板端命令都假定 CANN 运行时可用。
MindSpore 在异构计算栈中的位置
从框架到硬件的纵向分层
一次 MindSpore 推理或训练,自上而下经过这些层次:
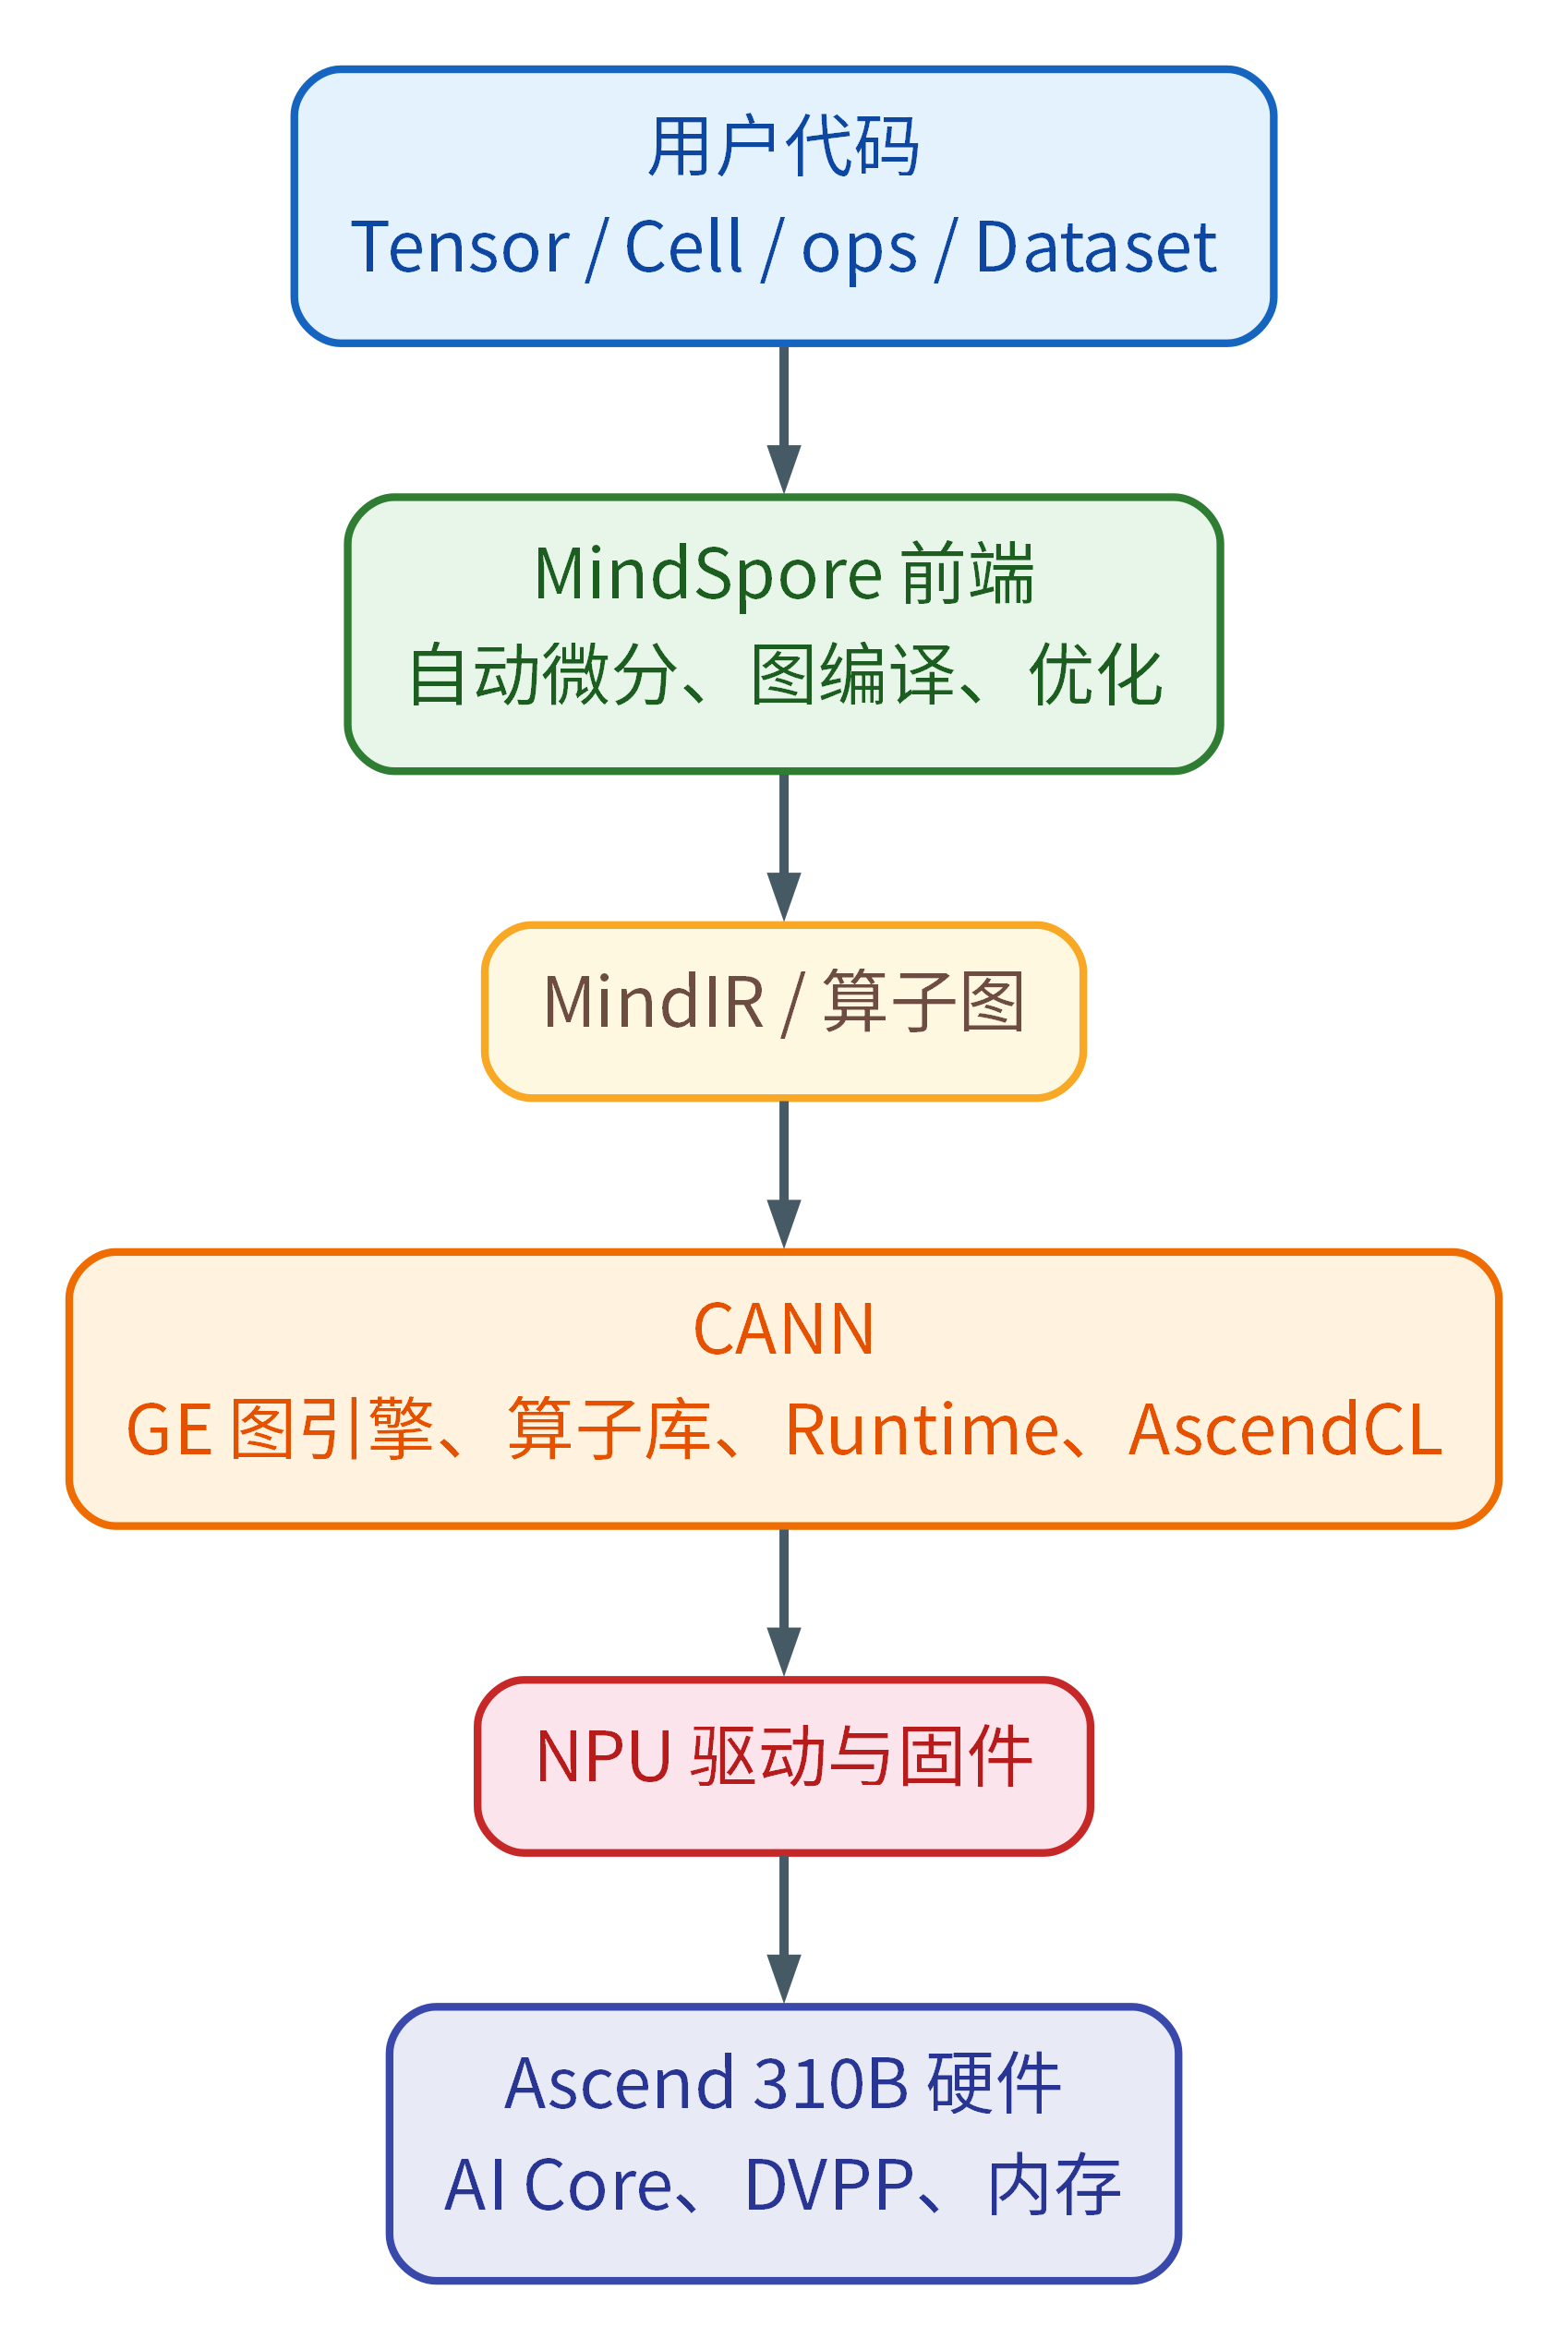
关键性质:MindSpore 不直接访问硬件寄存器。它把算子图交给 CANN 的图引擎和运行时,再由驱动访问设备。因此下面两类错误必须分开定位:
- “算子不支持”“图编译失败”“build_from_file 崩溃”属于框架/图编译层;
- “
acl初始化失败”“设备找不到”“内存分配失败”属于运行时/驱动层。
第 4 章强调的 PyACL 生命周期管理在 MindSpore 下依然成立,只是被框架封装起来了。当服务在加载模型阶段崩溃时,先把这两层切开,能省掉大量无效尝试。
MindSpore 与 PyACL、PyTorch 的分工
| 维度 | MindSpore | PyTorch + torch_npu | PyACL |
|---|---|---|---|
| 抽象层次 | 框架级 | 框架级 | 运行时级 |
| 网络定义 | nn.Cell + construct | nn.Module + forward | 不涉及 |
| 自动微分 | value_and_grad 原生支持 | 依赖 autograd | 不涉及 |
| 图执行 | 静态图(GRAPH_MODE)或动态图 | 依赖图编译与算子映射 | 手写图与执行 |
| 交付格式 | CKPT、MindIR | .pt、ONNX | OM |
| 典型场景 | 框架内训练与端侧推理 | 已有 PyTorch 资产迁移 | 精细控制设备资源 |
对本书其余章节的衔接:第 4 章的 OM 路线与本章的 MindIR 路线是两条并行的交付路径,不要把 MindIR 当作 OM 使用,也不要假设 OM 能被 MindSpore 直接加载。
环境与版本配套
安装前必须确认的四件事
- 板卡型号与算力档位:本书主要在
Ascend 310B4 / 8T上验证,310B1 / 20T结论必须单独记录,二者不可互相引用性能数字。 - CANN 版本与
set_env.sh:未 source 环境时,import mindspore可能成功,但实际执行阶段才失败。 - Python 版本与 wheel 的 ABI 标签:例如
cp39只能装在 Python 3.9 环境。 - 是否存在用户 site 与 conda 环境混用:这是本章最常见的假故障来源。
环境核验脚本
在板端同一 shell 中先激活 CANN,再运行 samples/chapter5/check_mindspore_env.py。它只读取版本与导入来源,并在独立子进程中做一次最小的设备加法探测,不修改任何包:
source /usr/local/Ascend/ascend-toolkit/set_env.sh
cd ~/Documents/Ascend310/samples/chapter5
python check_mindspore_env.py
脚本输出解释器、每个模块的版本与导入路径,并写入 outputs/env-report.json。本章记录到的板端结果:
| 项目 | 实测值 |
|---|---|
| 解释器 | Python 3.9.2,/usr/local/miniconda3/bin/python |
| CANN | 8.0.0(runtime/toolkit/opp 均为 7.6.0.1.220:8.0.0) |
| MindSpore | 2.4.10,从用户 site ~/.local/lib/python3.9/site-packages 加载 |
| MindSpore Lite | 2.2.11,同样来自用户 site |
| MindNLP | 0.4.1 |
| NumPy | 1.22.4 |
| Ascend 设备加法探测 | observed-pass |
输出里导入路径比版本号更重要。同一个板上同时存在两个 MindSpore 是常见现象:本章这块板的 conda site-packages 里存有另一个版本的 dist-info,实际生效的是用户 site 中的 2.4.10。只报告版本号而不报告路径,会让人误判究竟加载了哪一份。
同样重要的是选对解释器。这块板自带的 python3 是 3.10.12,其中没有 MindSpore;直接用 python3 运行样例会在导入阶段就失败。运行前用 which python 与脚本打印的 python_executable 交叉确认。
版本与导入顺序的三个陷阱
| 现象 | 真实原因 | 正确处理 |
|---|---|---|
设置 PYTHONNOUSERSITE=1 后 mindnlp 找不到 | 已验证的 wheel 装在用户 site,被隔离掉 | 对比隔离环境与实际启动环境,不要直接把隔离结果当作缺失 |
undefined symbol | 同一进程混用不同版本的 MindSpore 与 MindSpore Lite | 两个运行时分开进程验证,不要靠导入顺序“修好” |
| 导入成功但执行崩溃 | 只验证了 Python 层,未验证 Ascend 图执行 | 用最小算子或最小图做板端 smoke,再扩大范围 |
这些结论来自本仓库的两组记录:本轮 Ascend 310B4 / 8T 上 mindnlp 0.4.1 从用户 site 正常导入(observed-pass,见 samples/chapter5/outputs/env-report.json),而更早的报告中曾出现 mindnlp 不可导入、并与 Ascend 软件包版本不匹配的环境(blocked);同一时期的 Ascend 310B1 / 20T 板使用 MindSpore 2.4.10 + MindNLP 0.4.1 通过了完整机器门(observed-pass)。不同板卡、不同环境的结论不能互推:导入失败多数是路径与版本问题,不能当成硬件否定。
张量、数据类型与设备上下文
MindSpore 的核心数据结构是 Tensor。它和 NumPy 数组的差别不在于“能不能存数据”,而在于数据放在哪里、图如何追踪它。设备上下文由 set_context 设定,必须在创建张量之前调用:
import mindspore as ms
from mindspore import Tensor, ops

ms.set_context(mode=ms.PYNATIVE_MODE, device_target="Ascend", device_id=0)

a = Tensor([[1.0, 2.0], [3.0, 4.0]], ms.float16)
print(ops.matmul(a, a).asnumpy())
这段代码能通过,不是因为“矩阵乘在 310B 上一定能跑”,而是因为 dtype 是 fp16。把 dtype 换成 ms.float32,同一行在本板上会被拒绝:
RuntimeError: aclnnMatmulGetWorkspaceSize call failed
EZ1001: ... Self dtype DT_FLOAT or mat2 dtype DT_FLOAT not support under keep type mode.
samples/chapter5/01_tensor_ops.py 把四个探测分别放在独立子进程里执行,本板实测结果:
| 探测 | 结果 | 证据等级 |
|---|---|---|
ops.add,fp32 | 通过 | observed-pass |
ops.matmul,fp32 | 被 cube 单元拒绝(EZ1001) | observed-fail |
ops.matmul,fp16 | 通过,数值 [[7.0, 10.0], [15.0, 22.0]] | observed-pass |
同一矩阵乘在 CPU fp32 上 | 通过,与上面的 fp16 结果在 1e-2 内一致 | observed-pass |
只看形状会得到错误结论。同一块板上的对照实验是:只取 value.shape 而不读数值时,fp32 的 nn.Dense 前向与 ops.matmul 各有 2/2 次“通过”;加上 .asnumpy() 把结果搬回主机后,同样两条路径各 2/2 次失败并给出 EZ1001。打印形状不需要设备物化计算结果,而 .asnumpy() 必须完成这次同步。因此“某个算子在板上能跑”必须以取回的实际数值为依据。
其余要点:
Tensor的 dtype 显式给出,比依赖字面量推断更可靠;本板上fp32与fp16的差别不是精度取舍,而是能否执行;.asnumpy()会触发设备到主机的同步拷贝,不要放在性能敏感的循环里,但它是唯一能证明算子真正执行的方式;- 逐元素算子(如
add)与矩阵算子的 dtype 支持范围不同,不要用一个算子的通过结果推断另一个算子。
Parameter 是会被优化器更新的张量,Tensor 默认不是。这个区分在第 5.8 节训练循环中会直接影响“为什么梯度算了但权重没变”。
用 Cell 与 ops 构建网络
最小可运行的网络定义
nn.Cell 相当于 PyTorch 的 nn.Module:用 __init__ 声明子模块,用 construct 定义前向计算。下面这个网络在本板上是 observed-pass:
import numpy as np
import mindspore as ms
from mindspore import Tensor, nn, ops


class Fp16Linear(nn.Cell):
    """本板可用的最小线性层:显式 fp16 参数,矩阵乘走 ops.matmul。"""

    def __init__(self, in_dim: int, out_dim: int, seed: int = 0):
        super().__init__()
        rng = np.random.default_rng(seed)
        weight = rng.normal(scale=0.1, size=(in_dim, out_dim)).astype(np.float16)
        self.weight = ms.Parameter(Tensor(weight, ms.float16), name="weight")
        self.bias = ms.Parameter(Tensor(np.zeros((out_dim,), np.float16), ms.float16), name="bias")

    def construct(self, x):
        return ops.matmul(x, self.weight) + self.bias


net = nn.SequentialCell([Fp16Linear(4, 8, seed=1), nn.ReLU(), Fp16Linear(8, 1, seed=2)])
output = net(Tensor(np.ones((1, 4), np.float16), ms.float16))
print(output.shape, output.asnumpy())
对照写法 nn.Dense(4, 8) 由框架托管权重、代码更短,但在本板上让参数保持 fp32 时,同一次前向会在取回数值时被 EZ1001 拒绝。samples/chapter5/02_cell_network.py 用独立子进程记录的对照结果:
| 写法 | 结果 | 证据等级 |
|---|---|---|
显式 fp16 参数 + ops.matmul 的两层网络 | 前向通过,输出形状 [1, 1] | observed-pass |
nn.Dense,fp32 输入,取回数值 | aclnnMmGetWorkspaceSize / EZ1001 | observed-fail |
Dense→ReLU→Dense,fp32 输入,取回数值 | EZ1001 | observed-fail |
nn.Dense(4, 2).to_float(ms.float16) | 多次运行结局不一致:正常返回 / SIGSEGV(-11)/ 超时不返回 | observed-fail + blocked |
因此 to_float(ms.float16) 这类“让框架自动转换精度”的写法在本板上不可靠:同一段代码在多次运行中分别出现过正常返回、打印结果后以 SIGSEGV(返回码 -11)结束、以及超过 120 s 探测预算仍不返回三种结局。出现概率性进程级崩溃的写法不能作为交付路径,可靠做法是把 dtype 写进参数和输入本身。
这些探测都在独立子进程里执行,而且必须在父进程建立 Ascend 上下文之前完成。实测发现:父进程已经在跑 Ascend 算子时再启动子进程做设备计算,子进程会长期不返回(超过 120 s 探测预算),失败现象从“报 EZ1001”退化为“没有回包”。这不是算子本身变慢,而是同一个进程在持有设备上下文时又去启动第二个设备进程带来的竞争。把探测前置之后结论重新变得可重复。
与 PyTorch 的三处差异值得写在代码旁:
| 项目 | MindSpore | PyTorch |
|---|---|---|
| 前向方法名 | construct | forward |
| 全连接层 | nn.Dense | nn.Linear |
| 常用运算 | mindspore.ops | torch.* |
construct 这个名字不是风格问题:静态图模式下它被当作计算图入口处理,名字写错会导致子模块在图里被静默忽略。
什么时候用 ops,什么时候用 Cell
ops 是不可训练的函数式算子,Cell 是可持有参数、可组合的模块。经验规则:
- 无参数、纯计算(激活、矩阵乘、归一化函数)用
ops; - 有参数、需要被优化器发现(
Dense、Conv2d、自定义带权重层)用Cell子类。
自定义算子属于第 7 章的内容。本章只强调边界:图模式下 Python 的控制流和副作用不会按普通脚本执行,所以不要把“打印调试信息”当成确认算子执行顺序的手段。
数据集与预处理
GeneratorDataset 的组织方式
MindSpore 的数据管道由 Dataset 对象组合而成。一个可复现的最小例子是:先用 Python 生成器描述单样本,再映射出规范化后的样本,最后批处理。
import numpy as np
from mindspore.dataset import GeneratorDataset


def gen():
    rng = np.random.default_rng(0)
    for _ in range(64):
        vector = rng.normal(size=(4,)).astype(np.float32)
        yield vector, np.asarray([vector.sum()], dtype=np.float32)


def normalize(vector):
    return ((vector - np.float32(0.5)) / np.float32(2.0)).astype(np.float32)


dataset = (
    GeneratorDataset(gen(), column_names=["x", "y"], num_parallel_workers=1)
    .map(
        operations=normalize,
        input_columns=["x"],
        output_columns=["x"],
        num_parallel_workers=1,
        python_multiprocessing=False,
    )
    .batch(8, drop_remainder=True)
)
samples/chapter5/03_dataset_pipeline.py 用这段结构实测:64 个样本、batch_size=8 得到 8 个批次,批形状 [8, 4],同一随机种子重建后首批数据完全一致(observed-pass)。
要点:
- 随机源显式固定(
default_rng(0)),否则两次实验的 loss 曲线不可比较; map里返回的必须是显式 dtype 的 numpy 数组或Tensor,标量要包成单元素数组。返回未定型的标量会得到Failed to create tensor from numpy array, data type is unknown,这个错误来自数据管道而不是设备侧;map中的函数在数据管道进程/线程中执行,不要在里面访问设备上下文;batch之后张量形状固定,这对静态图编译很重要。
数据管道与设备内存的关系
数据预处理放在主机侧还是设备侧,会改变吞吐而不改变正确性。判断顺序是:
- 先确认数据读取不是瓶颈(否则优化算子没有意义);
- 再确认预处理是否占满 CPU;
- 最后才考虑把 resize、归一化下沉到 AIPP/DVPP——这条路径在第 6 章和第 8 章展开。
在没有测量前不要假设“预处理一定慢”。第 8 章的全部优化方法都建立在先测量之上。
静态图与函数式编程
两种执行模式
| 模式 | 设置方式 | 特点 | 适用场景 |
|---|---|---|---|
| 动态图(PyNative) | ms.set_context(mode=ms.PYNATIVE_MODE) | 逐行执行,调试方便 | 开发调试、定位错误 |
| 静态图(Graph) | ms.set_context(mode=ms.GRAPH_MODE) | 先构图再执行,可整体优化 | 训练与推理性能 |
推荐的工程顺序是先在 PyNative 下调通,再切 Graph 验证。直接写 Graph 模式会让语法错误、shape 错误和设备错误混在一起。
把函数编译成图
ms.jit 可以把单个函数编译成可复用的图:
import mindspore as ms


@ms.jit
def scaled_add(a, b, scale: float = 2.0):
    return (a + b) * scale
图模式下有三个必须遵守的约束:
- 不要依赖 Python 副作用(修改全局列表、打印计数)来观察执行;
- 避免随输入变化的结构(在
if中依据张量值改变网络结构); - shape 尽量稳定,动态 shape 会给图编译带来额外成本。
违反这些约束的表现通常不是清晰的报错,而是“结果和 PyNative 不一致”。因此 PyNative 与 Graph 的结果对比应当作为固定验证项。
samples/chapter5/04_graph_mode.py 用同一段计算在两种模式下各跑一次:
python 04_graph_mode.py --mode pynative
python 04_graph_mode.py --mode graph
两种模式下 @ms.jit 编译函数与普通函数都返回 13.0(observed-pass)。运行结果分别写入 outputs/04_graph_mode_pynative.json 与 outputs/04_graph_mode_graph.json。
还有一个容易卡住的细节:ms.jit 需要真实源码文件。在 python -c "..." 这种临时源码里调用它会直接报 Mindspore can not compile temporary source code in terminal,所以凡涉及 @ms.jit 的验证都要先落成文件再运行。
自动微分、优化器与训练循环
损失函数与梯度函数
MindSpore 的函数式微分接口是 value_and_grad:给定前向函数,返回(损失值,梯度)。
import mindspore as ms
from mindspore import ops


def make_grad_fn(net):
    def forward_fn(data, target):
        return ops.mse_loss(net(data), target)

    # grad_position=None:不对输入求梯度
    # weights=net.trainable_params():明确指定要被更新的参数
    return ms.value_and_grad(forward_fn, None, net.trainable_params())


loss, grads = make_grad_fn(net)(x, y)
optimizer(grads)
上面这种 grad_position=None + weights=net.trainable_params() 的写法是样例实际验证过的形式:前者表示不返回对输入的梯度,后者明确告诉框架要更新哪些参数。参数列表写错不会立刻报错,只会表现为“梯度算了但权重没变”,所以训练之后一定要检查 loss 是否真的下降。
一个完整的训练骨架
import mindspore as ms
from mindspore import nn, ops, value_and_grad


def build():
    model = MLP(in_dim=4, hidden=16, out_dim=1)
    optimizer = nn.Adam(model.trainable_params(), learning_rate=1e-2)
    return model, optimizer


def forward_fn(model, x, y):
    return ops.mse_loss(model(x), y)


def run(dataset, epochs: int = 5):
    model, optimizer = build()
    grad_fn = value_and_grad(forward_fn)
    model.set_train(True)
    for epoch in range(epochs):
        total, steps = 0.0, 0
        for x, y in dataset.create_dict_iterator():
            loss, grads = grad_fn(model, x, y)
            optimizer(grads)
            total += float(loss.asnumpy())
            steps += 1
        print(f"epoch {epoch}: loss={total / max(steps, 1):.6f}")
    return model
需要记住的三点:
model.set_train(True)与model.set_train(False)会切换 dropout、batch norm 等层的行为,推理前必须显式关闭;model.trainable_params()决定优化器能看到哪些参数,漏掉的层不会更新;- 每次取 loss 都用
.asnumpy()会引入设备同步,训练循环里建议按 step 累积后统一取出。
本板上的实测训练结果
samples/chapter5/05_autograd_train.py 用 Fp16Linear + nn.Adam 跑固定种子的合成线性回归,不需要下载任何权重:
python 05_autograd_train.py --steps 200 --lr 0.05本板三轮实测的 loss 都从 4.644531 降到约 7e-06,200 步耗时分别为 74.68 s、33.46 s 与 30.28 s。同样的代码在不同轮次之间有一倍以上差异,与会话中板卡温度从 80 ℃ 升到 95 ℃、npu-smi 持续显示 Health: Alarm 的状态一致。因此这条基线适合用来确认“自动微分—优化器—设备执行”整条链路是通的,不适合当作性能数字引用。
自动微分对 dtype 比前向更严格。同一个脚本把 nn.Dense 的 fp32 参数送进 value_and_grad 时,多次探测都以 EZ1001(The soc version does not support bf16 / fp32 for calculations)结束(observed-fail);也出现过超过 120 s 探测预算没有回包的情况(blocked)。两者指向同一个结论:本板上可训练路径必须显式使用 fp16,不要先写完标准 fp32 训练脚本再指望它跑通。
保存与加载:CKPT 与 MindIR
两种文件解决两个问题
| 格式 | 内容 | 用途 |
|---|---|---|
| CKPT | 参数字典 | 继续训练、微调 |
| MindIR | 计算图 + 参数 | 跨环境推理交付 |
import numpy as np
import mindspore as ms
from mindspore import Tensor

# net 与 reloaded 都是 5.5 节验证过的 Fp16Linear 网络
ms.save_checkpoint(net, "outputs/chapter5_linear.ckpt")

params = ms.load_checkpoint("outputs/chapter5_linear.ckpt")
ms.load_param_into_net(reloaded, params)

ms.export(
    net,
    Tensor(np.zeros((1, 4), np.float16), ms.float16),
    file_name="outputs/chapter5_linear",
    file_format="MINDIR",
)
samples/chapter5/06_checkpoint_mindir.py 在本板上的实测结果:
| 工件 | 实测值 | 证据等级 |
|---|---|---|
| CKPT | 60 字节,sha256: ca20a69f... | observed-pass |
| CKPT 重新加载后的数值对齐 | 最大绝对误差 0.0 | observed-pass |
| MindIR | 2796 字节,sha256: 12ade3bb... | observed-pass |
文件很小是正常的:它只是一个 4×1 的 fp16 线性层。体积小的好处是可以把“导出—校验—加载”三步完整放进教学样例,缺点是它无法代表真实模型的体积与算子复杂度。
导出的 MindIR 版本由框架版本决定,这一点在第 5.10 节会直接决定端侧推理能否加载。
交付前的最小检查清单
- CKPT 或 MindIR 的文件名、字节数与 SHA-256 已记录;
- 导出使用的 dtype、batch size 与输入形状已记录;
- 加载后做过一次数值对齐(同一输入下框架输出与文件输出一致);
- 说明该文件是在哪块板、哪个 CANN 版本下验证的。
第 4 条不是形式主义。本仓库的验收记录里,同一模型在不同板卡上出现过完全不同的结论,缺少硬件与版本标注的“已通过”无法复用。
MindSpore Lite 与端侧推理
Lite 是独立运行时
mindspore_lite 不是 mindspore 的简化 API,而是另一个运行时:它有自己的 wheel、自己的模型格式要求、自己的 Ascend 后端实现。两者混装在同一进程里,最容易出现的症状是符号解析失败。
Lite 的推理流程通常是:
import mindspore_lite as mslite

context = mslite.Context()
context.target = ["ascend"]
context.ascend.device_id = 0

model = mslite.Model()
model.build_from_file("model.mindir", mslite.ModelType.MINDIR, context)
outputs = model.predict([input_tensor])
310B4 上的实测边界
samples/chapter5/07_lite_inference.py 先用 CPU 后端确认工件本身是否被当前 Lite 接受,再用 Ascend 后端在独立子进程中尝试构图。本板实测:
| 检查项 | 结果 | 证据等级 |
|---|---|---|
Lite 2.2.11 导入(cp39/aarch64,用户 site) | 成功 | observed-pass |
MindSpore 2.4.10 导出的 MindIR 版本 | version 2 | observed-pass |
同一 MindIR 的 CPU 后端 build_from_file | 被拒绝:只支持到 version 1 | observed-fail |
同一 MindIR 的 Ascend 后端 build_from_file | 在同一格式校验处被拒绝 | observed-fail |
| LLM MindIR、placement、端侧性能 | 未执行 | not-run |
拒绝信息来自 Lite 自己的格式检查,位置在进入 Ascend 后端之前:
Build] Catch exception: This software can only support the maximum mind ir version: 1,
please install the latest version to support the mind ir version: 2这一点很重要:这一轮没有测到 Lite 的 Ascend 后端。失败停在“MindIR 版本 > Lite 支持的版本”这一层,因此它既不能证明 Lite 在 310B4 上不可用,也不能证明可用。要推进必须先做版本配套(换成能导出目标 MindIR 版本的 MindSpore,或换成支持 version 2 的 Lite),而不是反复重试同一个文件。
另一组更早的烟测来自 Ascend 310B1 / 20T 板、Lite 2.4.10/2.5.0 与 CANN 8.0.0:MobileNetV2 与最小 AddNet 的 MindIR 在 CPU 后端构建与预测成功;同一 MindIR 切到 Ascend 后端时进程以 SIGSEGV(退出码 139)结束;官方 .ms 文件在 Lite 2.5.0 中返回 Fail to support。原始记录在 samples/case9/docs/。这组结果属于另一台板、另一组 Lite 版本,只能作为对照,不能与本节的版本结论合并。
两条证据合起来给出的工程路径是:
- 端侧推理前先跑 CPU 后端,把“工件/格式问题”和“Ascend 后端问题”分开;
- 两个后端都停在版本校验时,要换版本配套,而不是调参数;
- 只有
build_from_file通过之后,讨论 placement 与端侧性能才有意义。
MindNLP 与大模型加载
本节是本章唯一引用 Ascend 310B1 / 20T 板数据的部分。samples/chapter5/ 的样例不下载、不加载任何大模型权重,8T 板上也没有运行过这一节的模型;本节用于说明“框架能跑通”与“某个模型能否加载”是两件事。
MindNLP 的定位
MindNLP 在 MindSpore 之上提供 Transformer 类模型实现、分词器和权重加载器。工程上有两个直接后果:
- 模型能否加载取决于 MindNLP 版本的 loader 覆盖范围。某个新模型架构没有对应 loader 时,这不是硬件问题,而是软件覆盖问题;
- 权重来源(Hugging Face Safetensors、Modelers 等)会带来不同的可复现性要求,例如 revision 能否固定、哈希能否锁定。
20T 板上的候选模型实测
实测环境为 Ascend310B1 / 20T、CANN 8.0.0、Python 3.9.2、MindSpore 2.4.10、MindNLP 0.4.1,使用既有 base 环境(dirty-base),未安装、升级或删除任何包:
| 模型 | 机器门结果 | 当前判定 |
|---|---|---|
| Qwen1.5-0.5B-Chat | health、models、JSON、SSE 与协议短回归通过;首 token p50 655.5 ms、总耗时 p50 1295.4 ms、约 1.544 token/s | observed-pass(仍为 experimental_dirty_base,人工质量待审) |
| TinyLlama-1.1B | 工件校验与加载通过;32 token 输出出现 U+FFFD,长输出超时 | blocked |
| DeepSeek-R1-Distill-Qwen-1.5B | 工件校验与加载通过;首次生成触发 TBE task_distribute 崩溃 | blocked |
| Qwen2.5-0.5B | 工件校验、加载、health/models 通过;首个 JSON 生成崩溃 | blocked |
| Qwen2.5-1.5B | 短输出通过;32 token 超时后 TBE 崩溃 | blocked |
| Qwen3-0.6B / Qwen3-1.7B | 未下载权重;MindNLP 0.4.1 无对应 loader | blocked(loader) |
| MiniCPM3-4B | 专用类可见,但官方来源 revision 为可变 main,无法锁定工件 | blocked(工件可复现性) |
这张表的读法比数字本身更重要:
blocked是针对该组合的结论,不是模型永久不兼容;- 多个模型在同一环境、同一 SoC 的生成阶段出现同类崩溃,支持“当前 MindSpore/MindNLP/CANN 版本与这些生成路径存在运行时阻断”的判断,但要继续推进应先做版本配套研究,而不是反复重试同一命令;
- Qwen3 的
blocked属于 loader 覆盖问题,与设备无关; - 只有 Qwen1.5 达到了可测量的端到端指标,因此其他模型没有可引用的性能数字。
工程上还应遵守两条纪律:下载入口可以换镜像(本仓库使用 HF_ENDPOINT=https://hf-mirror.com),但镜像只改变传输路径,不改变固定 revision 与 SHA-256 校验的硬门;同时只保持一个活动 worker,避免多个大模型同时占用设备内存。
在 310B 上运行的边界与证据记录
三条不可逾越的记录边界
- 8T 与 20T 分开记录。
Ascend 310B4 / 8T与Ascend 310B1 / 20T是不同算力档位,性能数字不得合并或互相转换。 - 环境改动必须显式声明。安装、升级、删除任何包之前先留存环境快照;使用
dirty-base时必须标注,不能把结果当作干净基线。 - 不通过就保持阻断。生成失败、内存不足、loader 缺失都应记录为
blocked/observed-fail并保留原始日志,不要用 CPU 后端或云端接口“补一个通过”。 - 执行证据必须包含数值。只打印 shape 会在本板上产生假阳性(5.4 节的对照实验就是如此);任何
observed-pass都要有取回的实际数值,或者明确的文件哈希与对齐差值。
一次实验应留存的内容
| 项目 | 具体内容 |
|---|---|
| 硬件与软件 | 板卡型号、算力档位、CANN/驱动/固件、Python、MindSpore、MindNLP |
| 工件 | 权重/模型文件名、字节数、SHA-256、revision |
| 命令 | 完整启动或加载命令、工作目录、环境变量 |
| 结果 | health/models/协议结果、首 token 与总耗时、吞吐、异常退出码 |
| 判定 | 每条结果标注 observed-pass / observed-fail / blocked / not-run |
| 路径 | 原始报告与日志在板上的绝对路径 |
只有这六项齐全,结论才能被下一个人复现;否则它只是一次性的观察。
本章样例留下的原始记录
| 记录 | 路径 |
|---|---|
| 全量样例运行汇总 | samples/chapter5/outputs/board-run-<时间戳>.json |
| 板端环境快照 | samples/chapter5/outputs/board-env-<时间戳>.json |
| 各样例报告 | samples/chapter5/outputs/*.json |
| 板端验证记录 | samples/chapter5/docs/01-board-validation-record-20261016.md |
| 20T 大模型验收 | samples/case9/docs/ |
outputs/ 已被仓库忽略:报告留在板上作为原始证据,不进版本库。凡是写进正文的数字,都必须能从这些报告回溯到具体的命令、退出码与版本组合。
常见错误与排查
| 症状 | 可能原因 | 处理方式 |
|---|---|---|
import mindspore 成功但执行报设备错误 | 未 source CANN 环境 | 在同一 shell 中先激活 CANN,再启动进程 |
EZ1001 ... not support under keep type mode | 矩阵计算传入了 fp32/bf16 | 把参数与输入显式改成 fp16,不要依赖自动转换 |
| 只打印 shape 显示成功,实际取不到结果 | 只做了形状检查,没有物化计算结果 | 用 .asnumpy() 取回数值,再判断该算子是否真的执行 |
| 子进程探测长时间不返回 | 父进程已经建立 Ascend 上下文并占用设备 | 把设备探测放到父进程初始化之前,或让父进程完全不做设备计算 |
Failed to create tensor from numpy array, data type is unknown | map 返回了未定型的 numpy 标量 | 返回显式 dtype 的数组,标量包成单元素数组 |
mindnlp 导入失败 | 用户 site 被 PYTHONNOUSERSITE=1 隔离 | 对比隔离与实际启动环境,确认实际加载路径 |
undefined symbol | 同一进程混用不同版本运行时 | 全量 MindSpore 与 Lite 分开进程验证 |
| 图模式结果与 PyNative 不一致 | 依赖了 Python 副作用或动态结构 | 把状态移出图,稳定 shape,再用最小用例二分 |
value_and_grad 梯度为空或权重不变 | grad_position/weights 写错,参数未纳入 trainable_params() | 明确指定 weights=net.trainable_params(),并检查 loss 是否下降 |
| 生成阶段进程消失 | TBE task_distribute 崩溃 | 保留日志与退出码,按 blocked 记录,先研究版本配套 |
| 设备内存分配失败 | 模型或批过大、多个 worker 并存 | 降低 batch/序列长度,保持单一活动 worker |
Lite 报 maximum mind ir version: 1 | MindIR 版本高于当前 Lite 支持的版本 | 换版本配套,而不是重试同一文件;先用 CPU 后端确认工件 |
to_float(ms.float16) 进程随机消失 | Ascend 上该自动转换路径不可靠 | 在参数与输入上显式指定 fp16,不要使用 to_float 作为交付路径 |
排查顺序建议固定为:先确认运行时环境 再确认工件完整性 再确认框架加载 最后才是图执行与性能。跳步会让不同层的问题混在一起。
小结
本章的核心结论可以压缩成八句话:
- MindSpore 处在 CANN 之上、用户代码之下,它把算子图交给 CANN 图引擎与运行时执行;
- 全量 MindSpore 与 MindSpore Lite 是两个独立运行时,版本与 ABI 不可混用;
- 网络用
nn.Cell与construct定义,训练用value_and_grad与优化器组织;本板可用路径是显式 fp16 参数与输入,nn.Dense的 fp32 前向与梯度路径被EZ1001拒绝; .asnumpy()既是同步点,也是执行证据:只报 shape 会在本板上产生假阳性;- CKPT 用于继续训练,MindIR 用于交付,两者都要留存哈希与对齐结果(本板实测 CKPT
60字节、对齐误差0.0,MindIR2796字节); - Lite
2.2.11只支持 MindIR version1,而 MindSpore2.4.10导出 version2,端侧推理当前阻断在格式版本层,这不是对 310B 硬件的否定; - MindNLP 决定大模型能否加载,其 loader 覆盖范围随版本变化,缺失属于软件边界;
- 所有板端结论必须带硬件档位、版本组合与证据等级,
blocked不等于unsupported。
实践任务
- 环境核验:运行
samples/chapter5/check_mindspore_env.py,记录解释器路径、各模块版本与导入路径、CANN 版本,整理成一页环境记录。 - dtype 边界:运行
01_tensor_ops.py,然后把矩阵乘的 dtype 从fp16改成fp32,分别用“只打印 shape”和“.asnumpy()取数值”两种方式判断,记录两次结论的差异。 - 最小网络:用
chapter5_models.py里的Fp16Linear搭一个二分类模型,在 PyNative 与 Graph 模式下各训练一次,比较 loss 曲线是否一致。 - 数据处理:在
03_dataset_pipeline.py的map里故意返回一个未定型的 numpy 标量,确认错误发生在数据管道阶段而不是图执行阶段,然后改回显式 dtype。 - 训练与导出:运行
05_autograd_train.py与06_checkpoint_mindir.py,记录 loss 起止值、耗时、文件字节数与 SHA-256,并做一次重新加载后的数值对齐。 - 边界记录:运行
07_lite_inference.py,把 CPU 与 Ascend 两个后端的结论分别记录,并说明阻断发生在格式版本层还是图构建层。
完成这些任务后,读者应能独立判断一次 MindSpore 失败发生在软件的哪一层,并按第 5.12 节的格式留下可复现的证据。